🛡️VulnSOC Assistant
VulnSOC Assistant
VulnSOC Assistant nació como mi Trabajo Fin de Máster en Ciberseguridad con el objetivo de desarrollar una aplicación web capaz de automatizar gran parte del análisis de vulnerabilidades CVE y ayudar en su priorización. Para ello la herramienta recopila información de fuentes oficiales y utiliza el inventario de activos de la organización para aportar contexto sobre qué sistemas podrían verse afectados. Además integra inteligencia artificial como apoyo para interpretar los datos obtenidos y presentarlos de una forma más clara y útil para el analista.
El proyecto también buscaba incorporar funcionalidades que agilizaran el trabajo diario como la exportación de los análisis en PDF, la búsqueda de vulnerabilidades por tecnología y versión, y el análisis múltiple de CVEs, permitiendo estudiar y priorizar varias vulnerabilidades de forma conjunta y reducir así el tiempo necesario para su revisión, todo ello centralizado en una única herramienta.
La primera versión estaba hecha con Python y Streamlit y me sirvió para comprobar que la idea funcionaba. El objetivo era automatizar el análisis de CVEs: introducir una vulnerabilidad, reunir información de varias fuentes y usar ese contexto para asignarle una prioridad y decidir qué debía revisarse antes sin depender únicamente del CVSS. Poco a poco fui añadiendo más funciones y VulnSOC empezó a crecer bastante.
Cuando terminé el TFM decidí seguir desarrollándolo, escalar el proyecto y mejorar todo lo que se me había quedado corto en la primera versión, tanto a nivel de funcionalidades como de diseño y arquitectura.
La primera versión cumplía bien su objetivo pero estaba bastante condicionada por Streamlit. Para el TFM tenía sentido porque me permitía centrarme en la lógica del proyecto y tener una aplicación funcional sin dedicar demasiado tiempo al frontend. Cuando decidí seguir desarrollando VulnSOC esas limitaciones empezaron a notarse mucho más sobre todo en el diseño, la organización de la interfaz y la separación entre frontend y backend. Por eso preferí no seguir trabajando sobre esa base y rehacer gran parte del proyecto con una arquitectura más flexible.
Así nació la versión actual de VulnSOC.
El cambio no se ha limitado a hacer una interfaz más moderna. Separé frontend y backend, revisé completamente el scoring, mejoré la relación entre vulnerabilidades e inventario, añadí nuevas formas de búsqueda y preparé un despliegue propio mediante Docker y Caddy.
Para desarrollar esta segunda versión también me he apoyado en Codex, sobre todo para trabajar sobre el código, probar cambios y mejorar distintas partes de la aplicación. Aun así las decisiones importantes sobre cómo funciona VulnSOC las he ido definiendo y revisando yo durante el desarrollo, incluido el sistema de priorización el cual se basa en reglas concretas y permite ver qué factores influyen en la puntuación de cada vulnerabilidad.
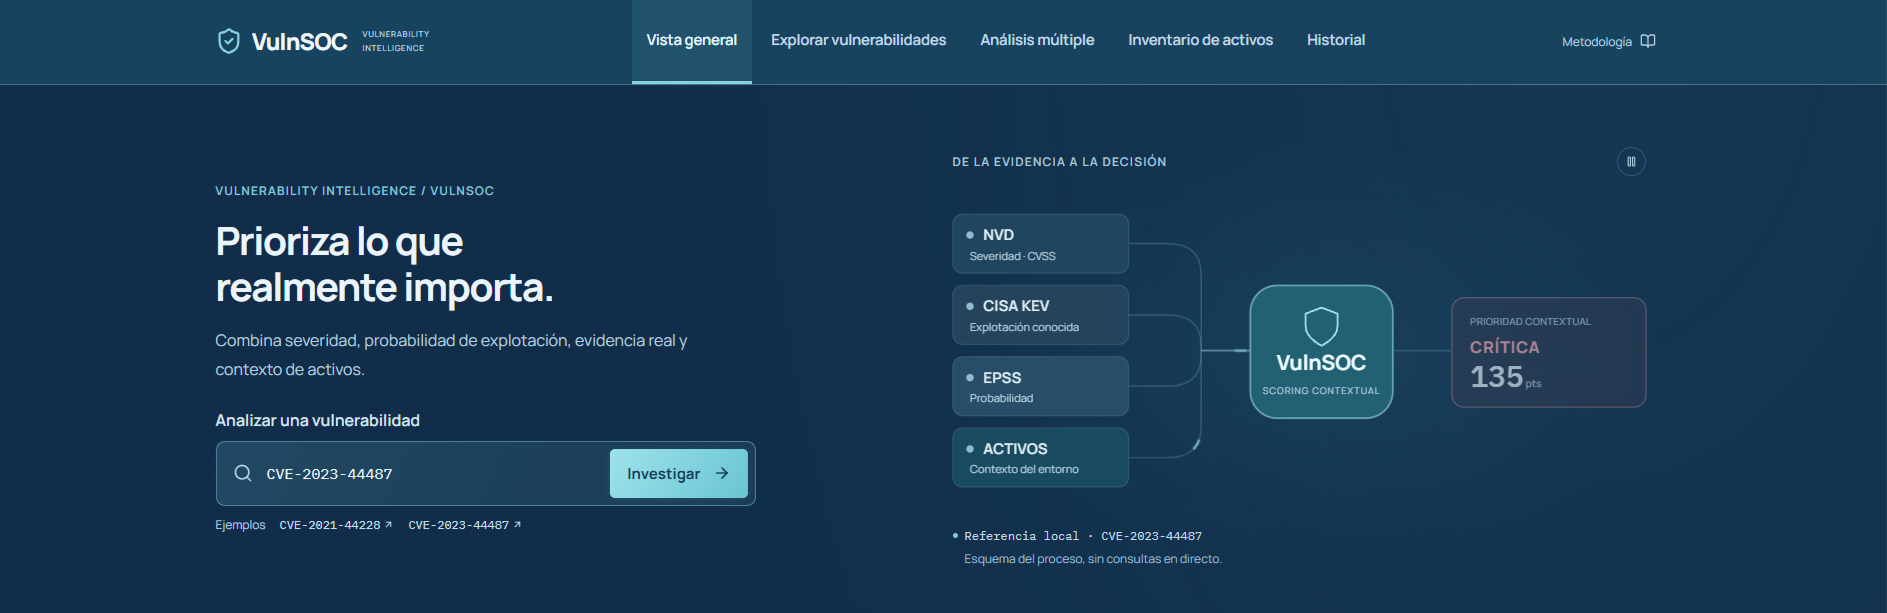
Aquí una imagen de como se vería la vista general de VulnSOC.
El problema que quería resolver
Cuando tienes varias vulnerabilidades delante mirar solo el CVSS se queda bastante corto.
Una vulnerabilidad con CVSS 9.8 parece automáticamente más urgente que otra con CVSS 8.1. El problema es que CVSS representa principalmente la severidad técnica y no todo el contexto que puede afectar a una decisión de priorización.
Me interesa saber si existe explotación real conocida, qué probabilidad de explotación estima EPSS y si la vulnerabilidad tiene relación con algún activo que realmente forma parte de mi entorno.
Ese es el punto de partida de VulnSOC.
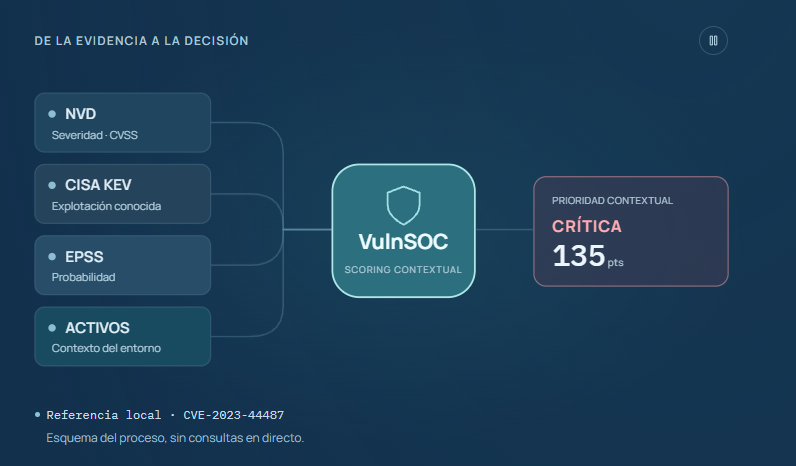
La aplicación no intenta sustituir las fuentes originales, su función es recopilar distintas señales y presentarlas juntas para facilitar el análisis.
Actualmente utilizo las siguientes fuentes:
- NVD, para obtener información técnica sobre el CVE y su CVSS.
- CISA KEV, para comprobar si existe explotación conocida documentada.
- FIRST EPSS, como estimación de la probabilidad de explotación.
A estas fuentes se añade el inventario introducido por el usuario.
El resultado es una puntuación propia que intenta responder a una pregunta distinta a CVSS:
¿Qué debería revisar primero dentro de este entorno?
Rehacer la arquitectura
La primera versión estaba construida alrededor de Streamlit. Para un TFM fue una forma rápida de tener una aplicación funcional pero cuando empecé a plantear la siguiente versión me encontraba demasiado limitado si quería controlar completamente la interfaz y hacer crecer el proyecto.
Para la nueva versión decidí separar el frontend y el backend en lugar de mantener toda la aplicación dentro de una misma tecnología.
La parte visual está desarrollada con React, TypeScript y Vite, mientras que FastAPI y Python se encargan de la lógica del backend. Entre ambos queda Caddy, que actúa como punto de entrada a la aplicación, gestiona HTTPS y dirige las peticiones de la API hacia FastAPI.
El historial y el inventario se mantienen en el propio navegador mediante IndexedDB, algo que explicaré con más detalle en la siguiente sección.
La arquitectura actual queda de esta forma:
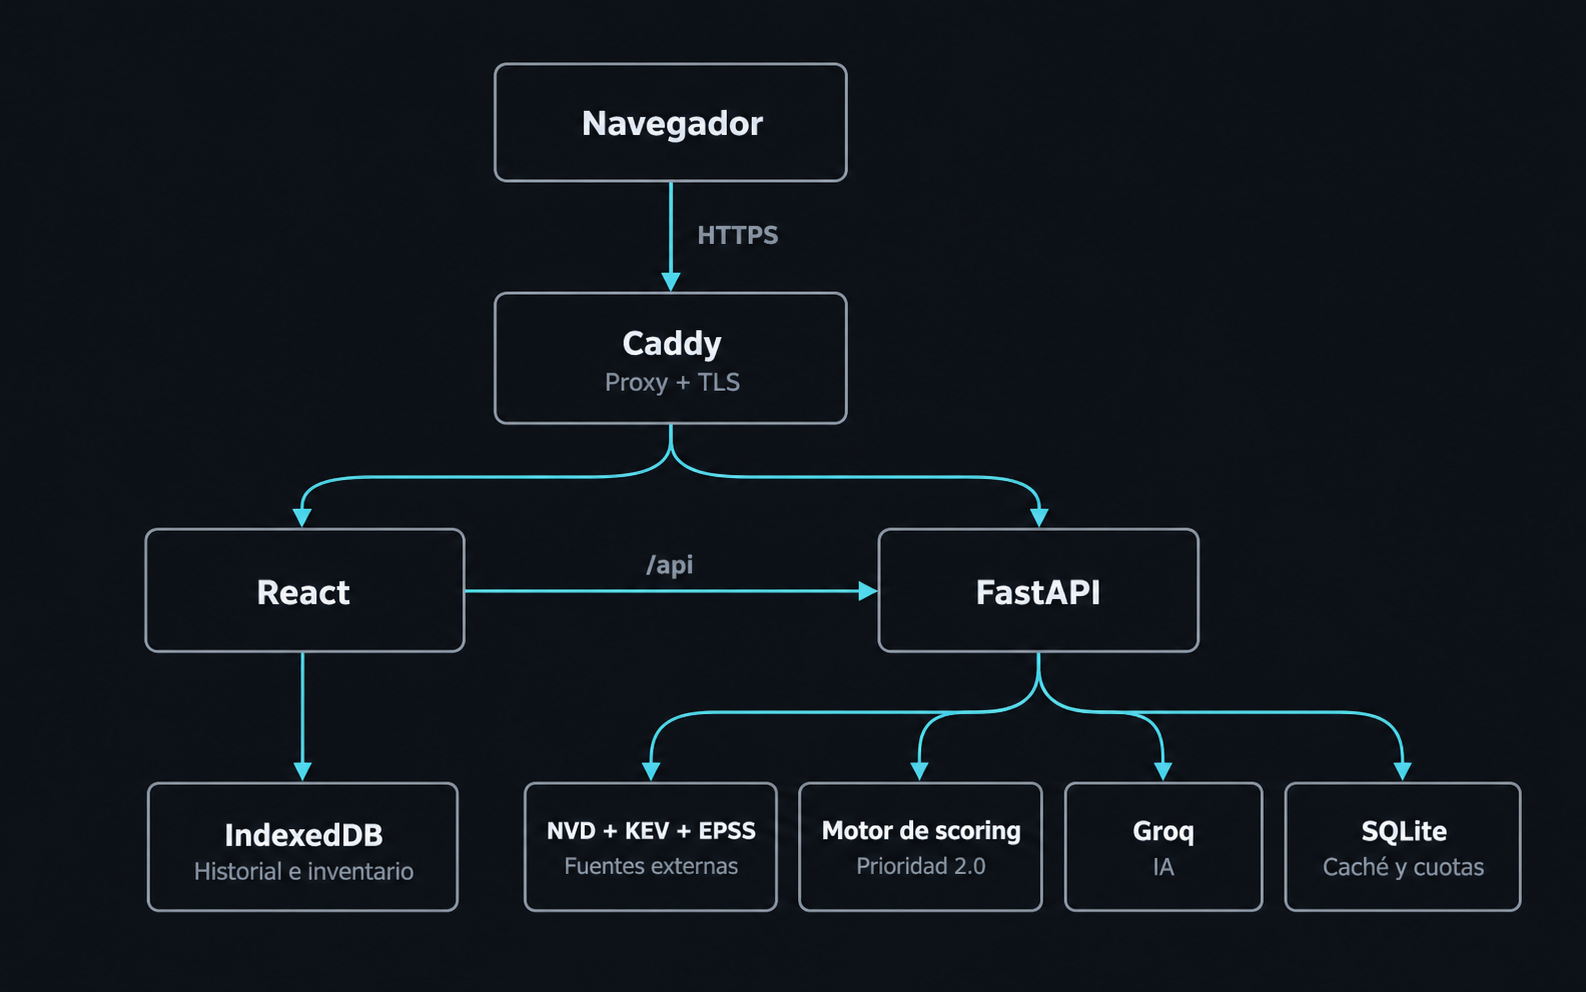
Este cambio me ha permitido trabajar con mucha más libertad. ya que la interfaz puede evolucionar de forma independiente mientras que el backend se centra en consultar las distintas fuentes, procesar la información y devolver los resultados que necesita VulnSOC.
Además tener ambas partes separadas hace que sea mucho más sencillo modificar o ampliar una de ellas sin tener que rehacer toda la aplicación.
Persistencia local en lugar de cuentas de usuario
Otra decisión importante de esta versión fue qué hacer con el historial y el inventario.
Podía haber creado un sistema de usuarios con autenticación y una base de datos central pero para el estado actual del proyecto me parecía añadir demasiada complejidad para algo que utilizo principalmente como herramienta pública y de portfolio.
Por eso decidí guardar esos datos directamente en el navegador mediante IndexedDB. De esta forma el historial y el inventario se mantienen entre sesiones sin necesidad de crear una cuenta ni almacenar de forma permanente esa información en el servidor.
Cuando VulnSOC necesita utilizar el inventario para analizar una vulnerabilidad toma temporalmente los datos necesarios para aportar contexto al CVE, como la criticidad del activo, su exposición o las tecnologías y versiones registradas.
El backend sí utiliza SQLite para algunas funciones internas de la aplicación, como caché o control de uso, pero no para guardar el historial personal de cada usuario.
La principal limitación de este enfoque es que los datos quedan asociados al navegador. Si cambio de equipo, utilizo otro perfil o elimino el almacenamiento local, esa información no se sincroniza automáticamente.
Para evitar depender completamente de un único navegador añadí también opciones de importación y exportación que permiten mover o conservar el espacio de trabajo cuando sea necesario.
Scoring 2.0
El sistema de priorización sigue siendo una de las partes principales de VulnSOC.
En la primera versión utilizaba más factores, pero al revisarlo me di cuenta de que algunos podían estar reforzando información que ya aparecía reflejada en el propio CVSS. Por ejemplo si el CVSS ya tiene en cuenta que una vulnerabilidad puede explotarse de forma remota, volver a sumar puntos por ese mismo motivo puede terminar dando demasiado peso a una señal parecida.
Para esta nueva versión preferí simplificar el modelo y quedarme únicamente con factores que pudiera justificar de forma clara.
La metodología actual parte del CVSS y añade contexto procedente de CISA KEV, EPSS y el inventario de activos:
| Factor | Puntos |
|---|---|
| CVSS | CVSS × 10 |
| CISA KEV | +60 |
| EPSS ≥ 1 % | +10 |
| EPSS ≥ 10 % | +20 |
| EPSS ≥ 70 % | +30 |
| Producto y versión compatibles | +5 |
| Activo de criticidad media | +5 |
| Activo de criticidad alta | +15 |
| Activo expuesto a Internet | +15 |
La idea no es calcular una probabilidad exacta de que una vulnerabilidad vaya a ser explotada.
El score funciona como una forma de priorizar. Cuantas más señales relevantes aparecen alrededor de una vulnerabilidad, más arriba debería quedar dentro de la lista de cosas que merece la pena revisar primero.
KEV tiene prioridad sobre EPSS
Para evitar sumar dos veces factores muy parecidos VulnSOC no acumula KEV y EPSS al mismo tiempo.
EPSS sirve como estimación de la probabilidad de explotación mientras que CISA KEV indica que ya existe evidencia de explotación conocida.
Por eso si una vulnerabilidad aparece en CISA KEV significa que ya existe evidencia de explotación y esa señal pasa a tener más peso dentro del scoring que EPSS. En ese caso EPSS se sigue mostrando como información adicional pero deja de sumar puntos para no contar dos veces prácticamente el mismo factor.
Si la vulnerabilidad no está en KEV entonces sí se tiene en cuenta EPSS. Cuanto mayor sea la probabilidad estimada de explotación, más puntos puede añadir al scoring.
Así evito inflar la puntuación utilizando dos indicadores relacionados con la explotación de una misma vulnerabilidad.
Los niveles de EPSS tampoco se acumulan
EPSS se aplica por tramos y solo se utiliza el nivel más alto que corresponda a cada vulnerabilidad.
El cálculo funciona así:
-
Menos del 1 %: +0 puntos
-
Desde el 1 % hasta menos del 10 %: +10 puntos
-
Desde el 10 % hasta menos del 70 %: +20 puntos
-
Desde el 70 %: +30 puntos
Por ejemplo si una vulnerabilidad tiene un EPSS del 75 % recibiría +30 puntos.
No recibe +10, +20 y +30 al mismo tiempo. Solo se aplica el tramo correspondiente.
Así evito que EPSS tenga más peso del previsto dentro de la puntuación
El inventario tampoco suma indefinidamente
El inventario también está pensado para aportar contexto sin hacer que la puntuación crezca simplemente porque haya más equipos registrados.
Si varios activos utilizan una versión compatible con la misma vulnerabilidad VulnSOC no suma puntos por cada uno de ellos.
En su lugar toma como referencia el activo compatible que más peso aporta al análisis, teniendo en cuenta factores como su criticidad o si está expuesto a Internet.
De esta forma una organización con diez equipos vulnerables no obtiene automáticamente un score mayor que otra con uno solo por el simple hecho de tener más activos en el inventario.
La cantidad de máquinas relacionadas sigue siendo información útil para el analista pero no aumenta por sí sola la puntuación.
La puntuación no es un porcentaje
La puntuación de VulnSOC representa puntos de prioridad y no un porcentaje de riesgo ni una probabilidad de explotación.
Actualmente utilizo estos umbrales:
| Puntuación | Prioridad |
|---|---|
| 0–54 | BAJA |
| 55–89 | MEDIA |
| 90–129 | ALTA |
| 130 o más | CRÍTICA |
Por ejemplo una vulnerabilidad con 150 puntos no tiene un 150 % de riesgo. Simplemente ha acumulado suficiente contexto como para quedar dentro del nivel crítico según la metodología de VulnSOC.
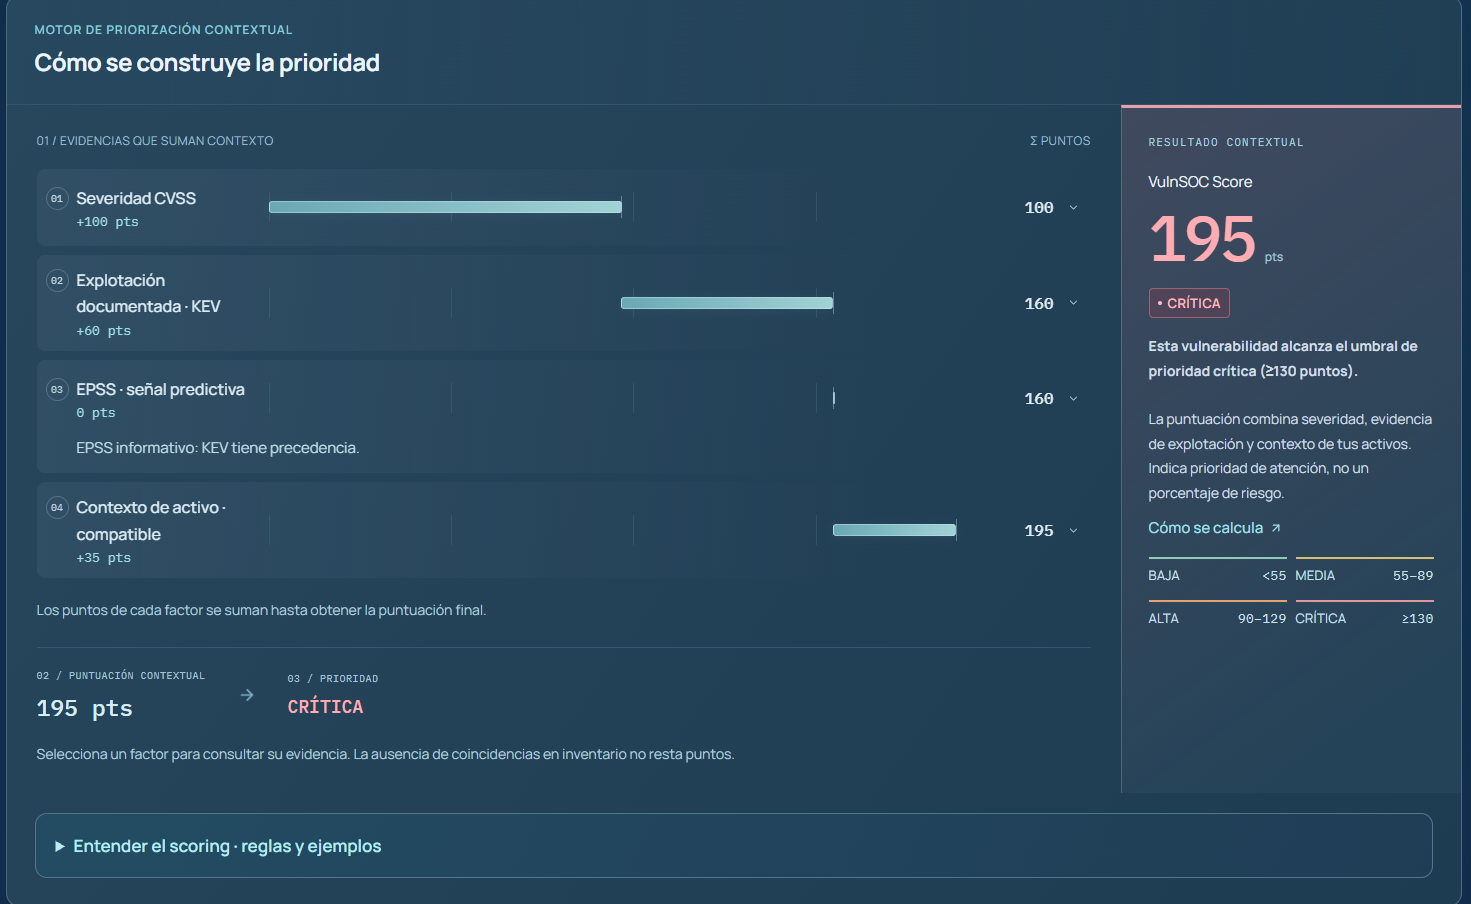
Log4Shell sirve bastante bien para verlo.
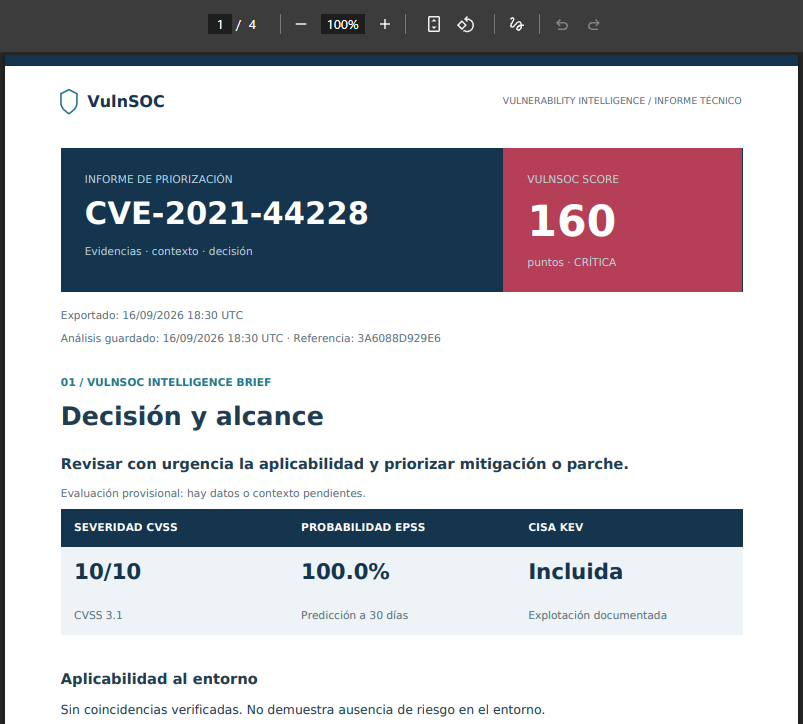
Su CVSS 10 aporta 100 puntos y al estar incluida en CISA KEV suma otros 60. Solo con esas dos señales ya alcanza 160 puntos y queda clasificada como crítica incluso antes de tener en cuenta el inventario.
Más que fijarme únicamente en el número final lo que me interesa es poder abrir el análisis y entender de dónde sale esa puntuación y qué factores han influido en ella.
Desconocido no significa cero
Durante el desarrollo me encontré con un problema que al principio parece pequeño pero que puede cambiar bastante el resultado de un análisis, ese problema era qué hacer cuando falta información.
Si EPSS no devuelve un valor eso no significa que la probabilidad sea cero. Si NVD todavía no ha publicado un CVSS, tampoco significa que la vulnerabilidad tenga severidad cero. Y si VulnSOC no consigue relacionar un CVE con ningún activo no puedo asumir automáticamente que no afecte al entorno.
Por eso decidí tratar cero y desconocido como cosas distintas.
Cuando faltan datos importantes VulnSOC intenta mostrar esa ausencia en lugar de sustituirla por un valor que pueda dar una falsa sensación de precisión.
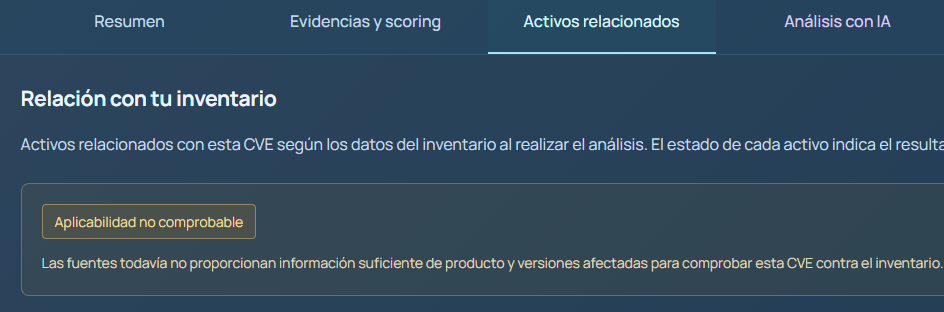
También existe el estado SIN DETERMINAR para los casos en los que todavía no hay información suficiente para clasificar una vulnerabilidad con confianza.
Esto ocurre sobre todo con CVEs recientes que pueden aparecer publicados antes de disponer de CVSS, rangos CPE completos o suficiente información en las distintas fuentes.
Prefiero que la aplicación diga claramente que todavía no puede determinar algo antes que mostrar una respuesta aparentemente exacta basada en datos incompletos.
El inventario
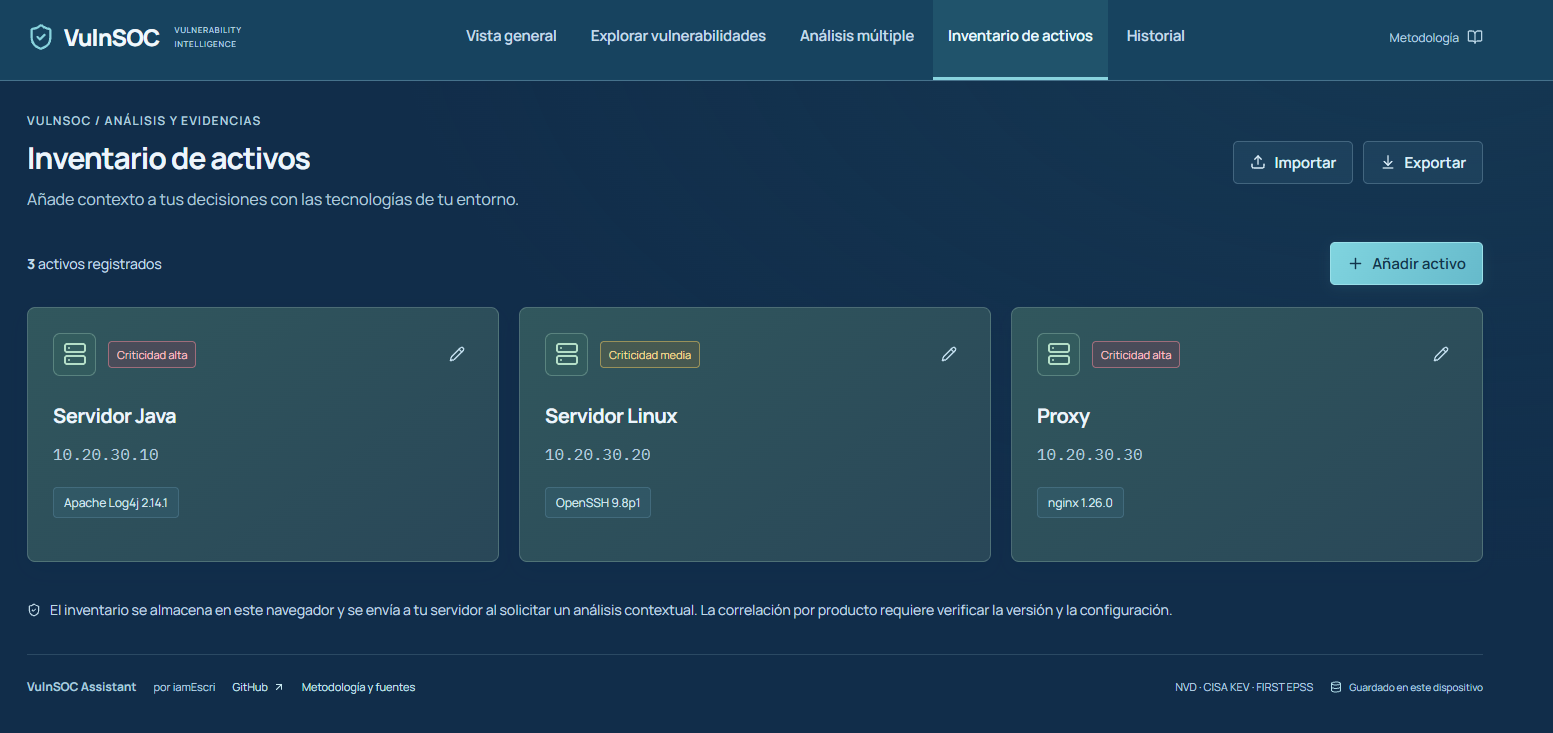
El inventario parecía una de las partes más sencillas del proyecto: registrar activos, indicar qué software utilizan y comprobar si una vulnerabilidad podría tener relación con ellos.
En la práctica ha sido una de las funcionalidades que más he tenido que revisar.
Cada activo puede guardar información como:
- Nombre
- IP o hostname
- Criticidad
- Exposición
- Tecnologías
- Versiones
Uno de los detalles importantes es que la exposición a Internet la indica el propio usuario.
VulnSOC no intenta deducirla automáticamente ni escanea los equipos para comprobarlo.
Lo hice así porque una vulnerabilidad pueda explotarse por red no significa que un servidor concreto esté realmente expuesto a Internet. Son cosas diferentes y preferí que ese contexto viniera del inventario real del usuario en lugar de asumirlo a partir de la vulnerabilidad.
Relacionar un CVE con un activo no es trivial
Al principio esta parte funcionaba con coincidencias de texto bastante simples pero enseguida aparecieron problemas.
Por ejemplo, encontrar la palabra Apache en dos sitios distintos no significa que estemos hablando del mismo producto. Una vulnerabilidad de Apache Tomcat no debería relacionarse con Apache Log4j solo porque ambos compartan el nombre del proyecto.
Por eso fui haciendo la comparación más estricta. La versión actual intenta identificar mejor el producto y cuando dispone de suficiente información también compara la versión registrada en el inventario con los rangos publicados por NVD.
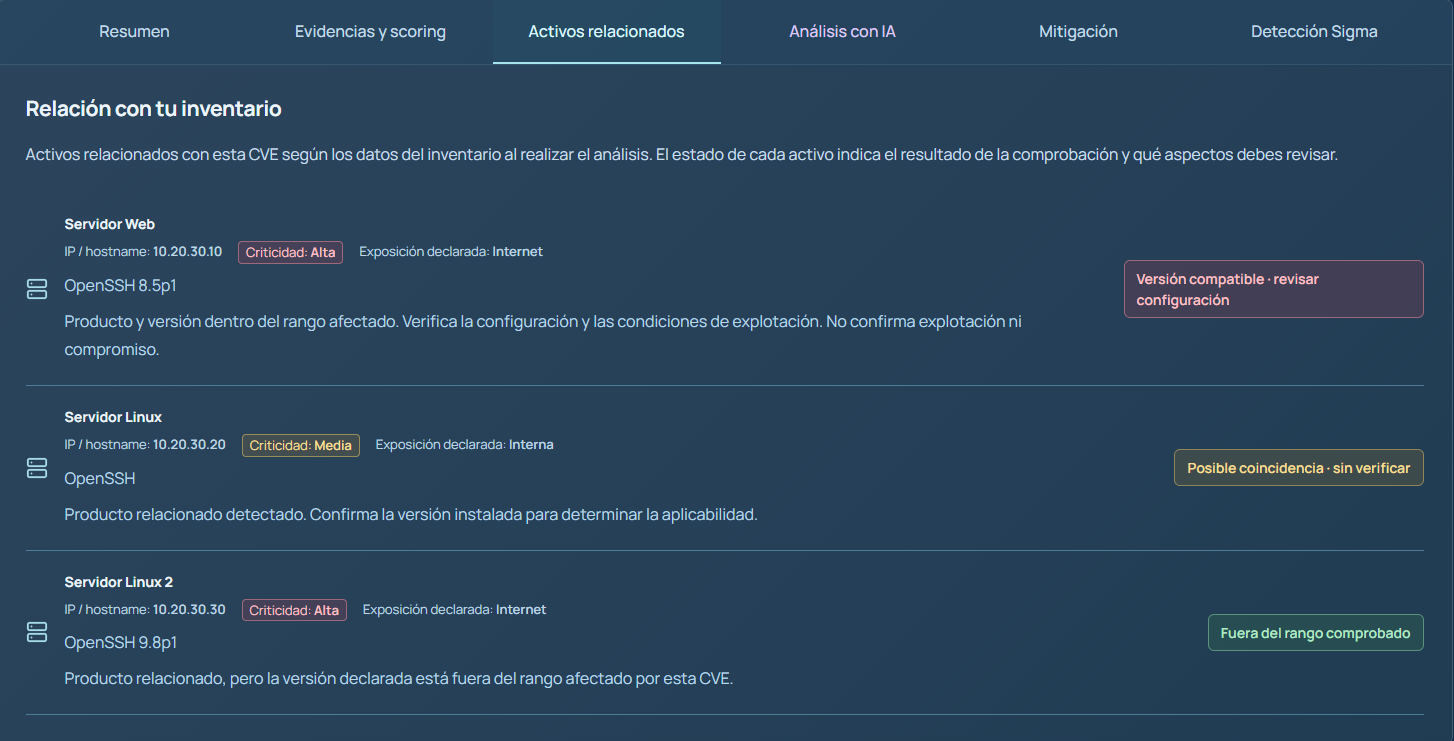
A partir de ahí VulnSOC puede distinguir varios estados según el nivel de información disponible.
Versión compatible
El producto coincide y la versión introducida se encuentra dentro de un rango que VulnSOC ha podido comprobar.
Ese activo puede aportar contexto al scoring.
Aun así evito mostrar simplemente la palabra afectado.
Una versión compatible no demuestra necesariamente que la configuración concreta del sistema permita explotar la vulnerabilidad.
Posible coincidencia
Existe relación con el producto pero falta información suficiente para comprobar completamente la versión o las condiciones necesarias.
En ese caso se muestra como pendiente de revisión.
No suma los mismos puntos que una compatibilidad comprobada.
Fuera del rango comprobado
La versión introducida queda fuera de los rangos que VulnSOC ha conseguido evaluar.
Tampoco utilizo este resultado como equivalente a seguro.
Significa únicamente que esa versión no se encuentra dentro del rango que se ha podido comprobar.
Aplicabilidad no comprobable
Como comentaba antes, en VulnSOC intento diferenciar siempre entre no afectado y no comprobable.
Cuando la aplicación no tiene información suficiente para validar correctamente la relación entre un CVE y un activo, prefiero mostrarlo de forma explícita antes que dar una respuesta demasiado optimista.
En la práctica el resultado puede quedar en distintos estados según lo que VulnSOC haya podido verificar, por ejemplo compatible, fuera de rango comprobado o aplicabilidad no comprobable.
Esta parte tiene todavía limitaciones.
Las configuraciones CPE pueden representar situaciones bastante más complejas que una simple comparación de versiones.
Cuando VulnSOC encuentra una situación que no puede interpretar con suficiente confianza prefiero mostrar el resultado como pendiente de comprobación antes que dar un resultado que pueda no ser correcto.
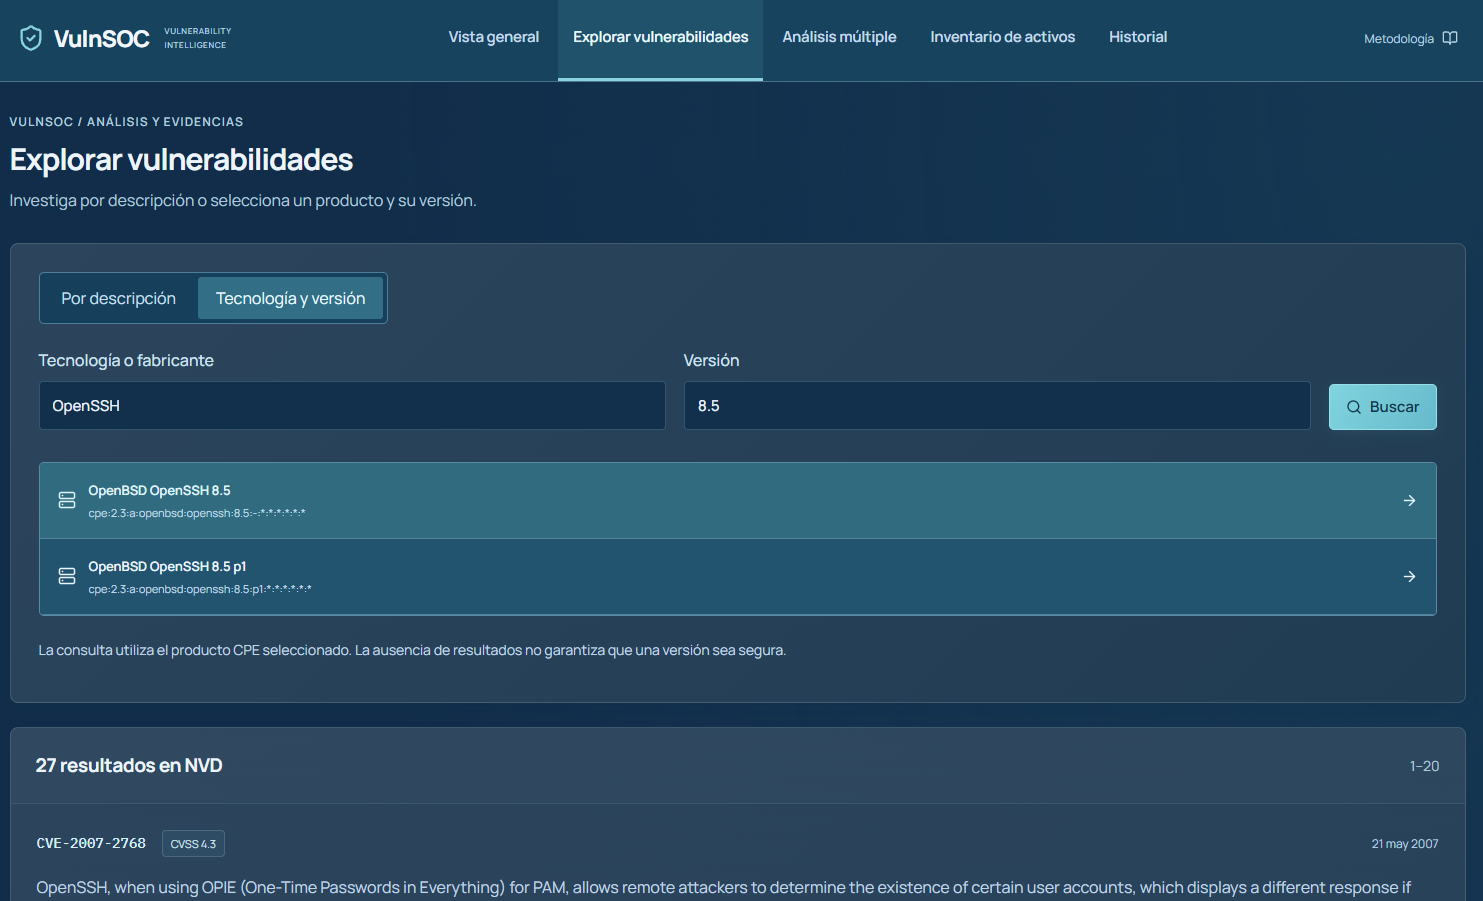
Explorar vulnerabilidades
No siempre empiezo un análisis conociendo el identificador exacto de un CVE.
A veces lo único que conozco es la tecnología que estoy utilizando, por lo que añadí una sección para buscar vulnerabilidades relacionadas con un producto o tecnología concreta. Esto puede ser útil para descubrir CVEs que merece la pena revisar aunque todavía no conozca su identificador.
Por eso añadí una sección para explorar vulnerabilidades de dos formas diferentes.
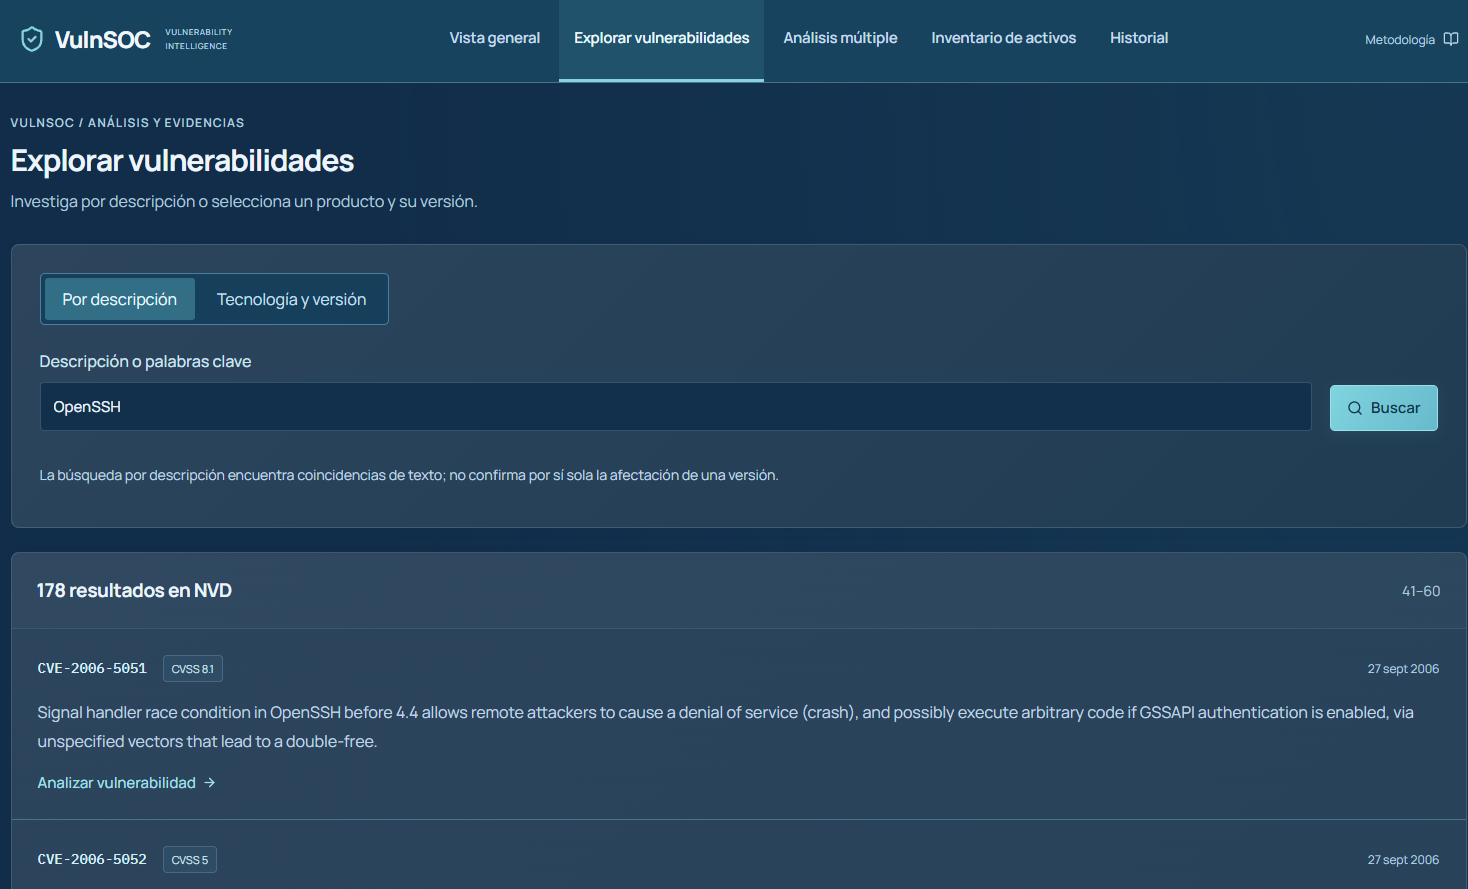
Búsqueda por descripción
La primera permite buscar términos dentro de las vulnerabilidades publicadas.
Por ejemplo:
OpenSSH
nginx
remote code execution
Este método es útil para explorar información pero una coincidencia textual no demuestra que una versión concreta de un producto esté afectada.
Por eso la utilizo principalmente como mecanismo de descubrimiento.
Tecnología y versión
Cuando conozco exactamente el software que quiero investigar puedo utilizar una búsqueda más específica.
Primero se localiza el producto dentro del catálogo CPE.
Después se selecciona la entrada correspondiente y se introduce la versión.
A partir de ahí VulnSOC puede buscar vulnerabilidades relacionadas con ese producto utilizando información más estructurada que una simple búsqueda textual.
La ficha de una vulnerabilidad
Cuando VulnSOC termina un análisis intento que la información más importante se pueda entender de un vistazo.
En la parte superior se muestran juntas señales como:
- prioridad VulnSOC
- puntuación
- CVSS
- EPSS
- presencia en CISA KEV
Así puedo tener una primera idea de la situación antes de entrar en los detalles.
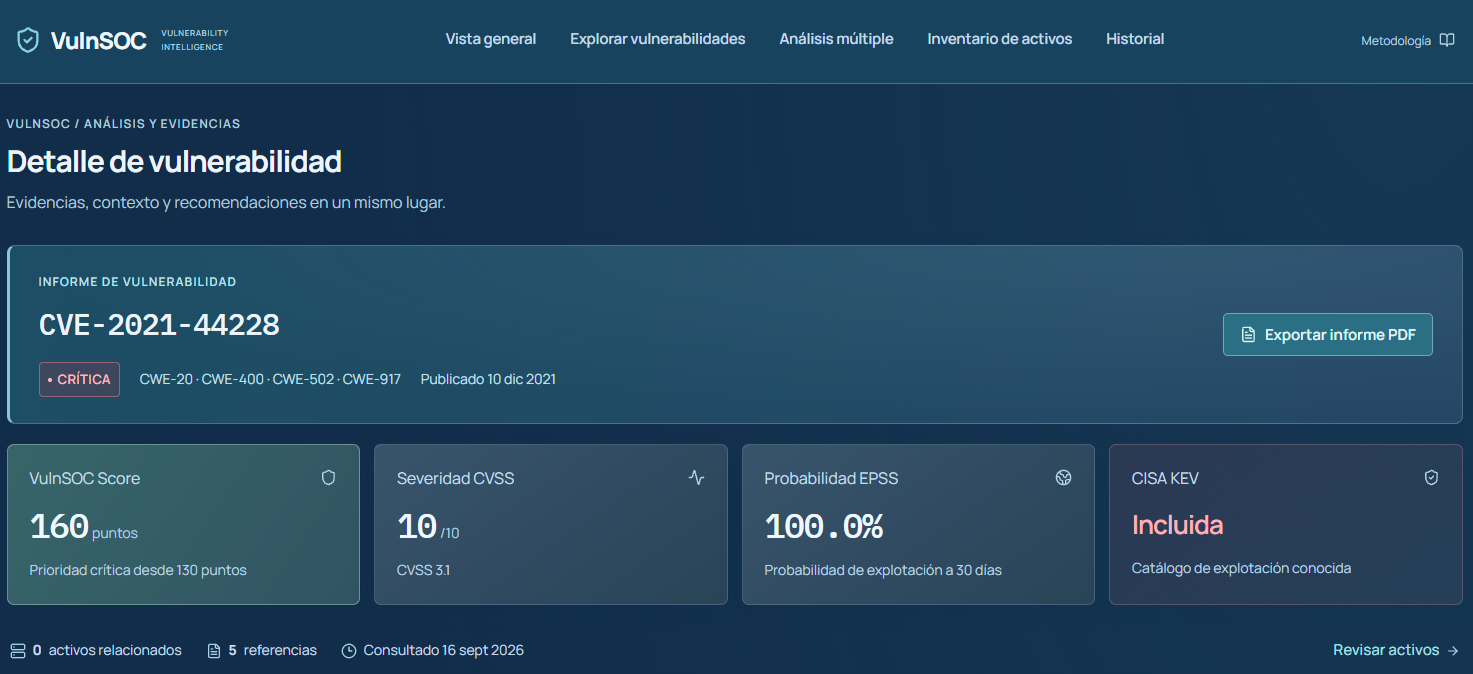
A partir de ahí puedo profundizar en el resto del análisis: descripción original, productos relacionados, scoring, activos del inventario, análisis con IA, mitigación, detección y referencias.
La idea es tener en una misma vista la información que normalmente tendría que consultar por separado en varias fuentes.
La IA interpreta el contexto, no calcula la prioridad
La inteligencia artificial sigue teniendo un papel importante dentro de VulnSOC pero en esta versión he intentado dejar mucho más claro hasta dónde llega.
El scoring se calcula antes de enviar ninguna información al modelo. La IA no decide si una vulnerabilidad es crítica, alta, media o baja, sino que recibe el contexto que VulnSOC ya ha recopilado y lo utiliza para ayudar a interpretar el resultado.
A partir de esa información puede generar un resumen ejecutivo, un análisis técnico y un plan de mitigación.
También intento que el modelo reconozca cuándo faltan datos en lugar de completar esos huecos por su cuenta. Esto ayuda a reducir las alucinaciones, aunque no las elimina por completo, por lo que el contenido generado sigue necesitando revisión.
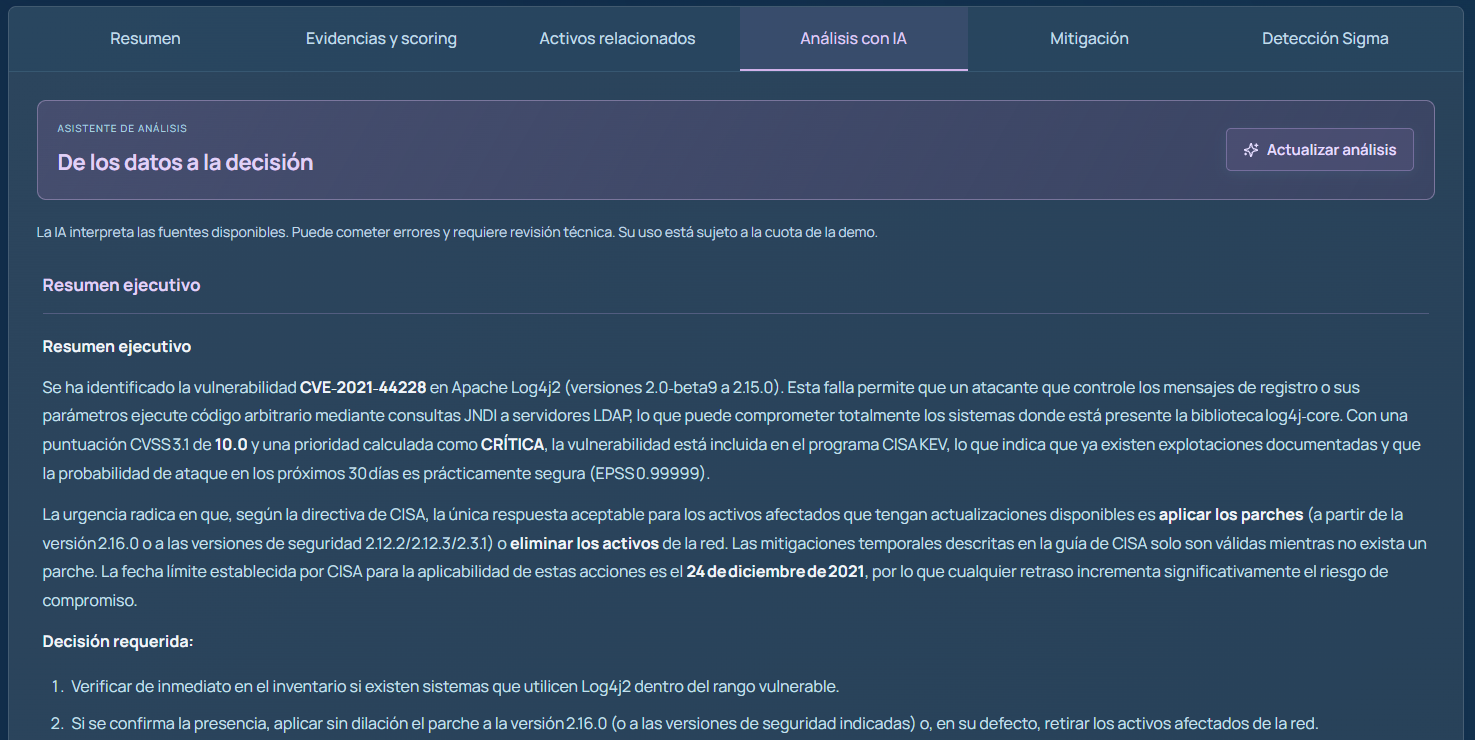
Además no quería que toda la aplicación dependiera de tener acceso al LLM.
Si se alcanza el límite del proveedor o la IA deja de estar disponible temporalmente VulnSOC puede seguir consultando NVD, KEV y EPSS, calcular el scoring y trabajar con el inventario. Lo único que deja de funcionar es la parte que necesita directamente al modelo.
Esto me permite mantener la IA como una ayuda dentro del análisis sin convertirla en un requisito para que la herramienta pueda seguir funcionando.
IA local y servidores propios
Otra mejora que quería añadir era la posibilidad de utilizar VulnSOC sin depender obligatoriamente de una API de IA externa.
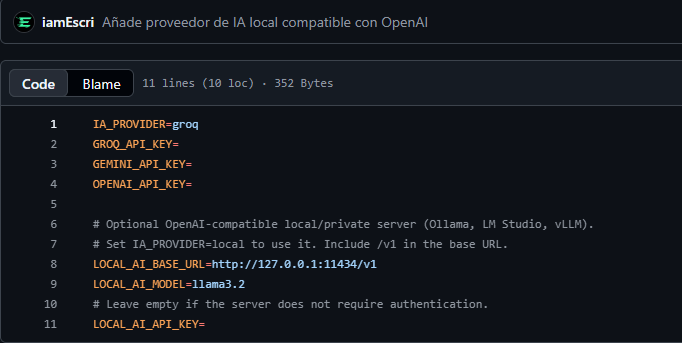
La aplicación puede conectarse a un modelo ejecutado en local o a un servidor privado compatible con la API de OpenAI. Esto permite utilizar herramientas como Ollama, LM Studio o vLLM, además de otros servidores que utilicen el mismo formato.
Con esto VulnSOC sigue recopilando y procesando la información de la misma forma pero el análisis generado por IA puede enviarse a un modelo alojado por el propio usuario en lugar de utilizar un proveedor externo.
Esto puede ser especialmente interesante en entornos donde se necesite tener más control sobre los datos enviados al modelo, utilizar infraestructura propia o simplemente evitar depender del consumo de una API externa.
Además cambiar el proveedor de IA no modifica el scoring ni el resto de la lógica de VulnSOC. La IA sigue teniendo exactamente el mismo papel: interpretar el contexto que la aplicación ya ha recopilado.
La configuración completa para utilizar modelos locales o servidores propios está disponible en el repositorio del proyecto.
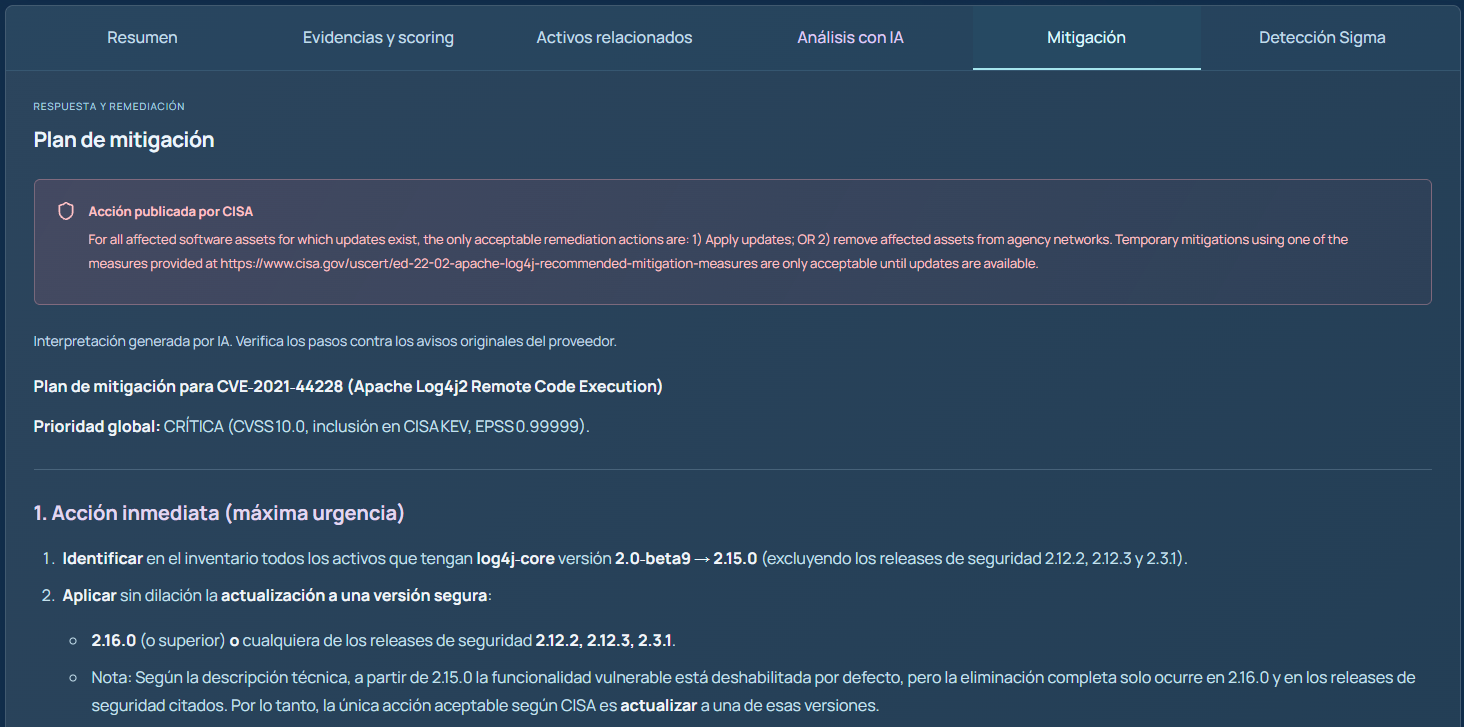
Mitigación
En esta parte he intentado separar claramente lo que viene de una fuente externa de lo que genera la IA.
Cuando una vulnerabilidad aparece en CISA KEV, VulnSOC puede mostrar la acción recomendada asociada a ese registro. Esa información se presenta como dato de la propia fuente.
Después la IA puede generar un plan de mitigación más desarrollado utilizando el contexto recopilado durante el análisis.
Ambas cosas pueden resultar útiles, pero no tienen el mismo nivel de confianza.
El plan generado por IA sirve como apoyo y punto de partida, pero antes de aplicar cambios sobre un sistema real considero necesario revisar siempre el advisory del fabricante y las referencias originales.
Detección Sigma
VulnSOC también permite trabajar con reglas Sigma orientadas a SIEM, de forma que el análisis de una vulnerabilidad pueda servir también como punto de partida para preparar su detección.
Para esta parte sigo una idea parecida: si ya existe una regla publicada, prefiero utilizarla como referencia antes que generar una nueva desde cero.
VulnSOC busca primero si existe alguna detección relacionada en SigmaHQ. Cuando encuentra una regla válida, la muestra manteniendo su procedencia para que quede claro de dónde viene.
Si no existe una regla adecuada, la IA puede generar un borrador en formato Sigma.
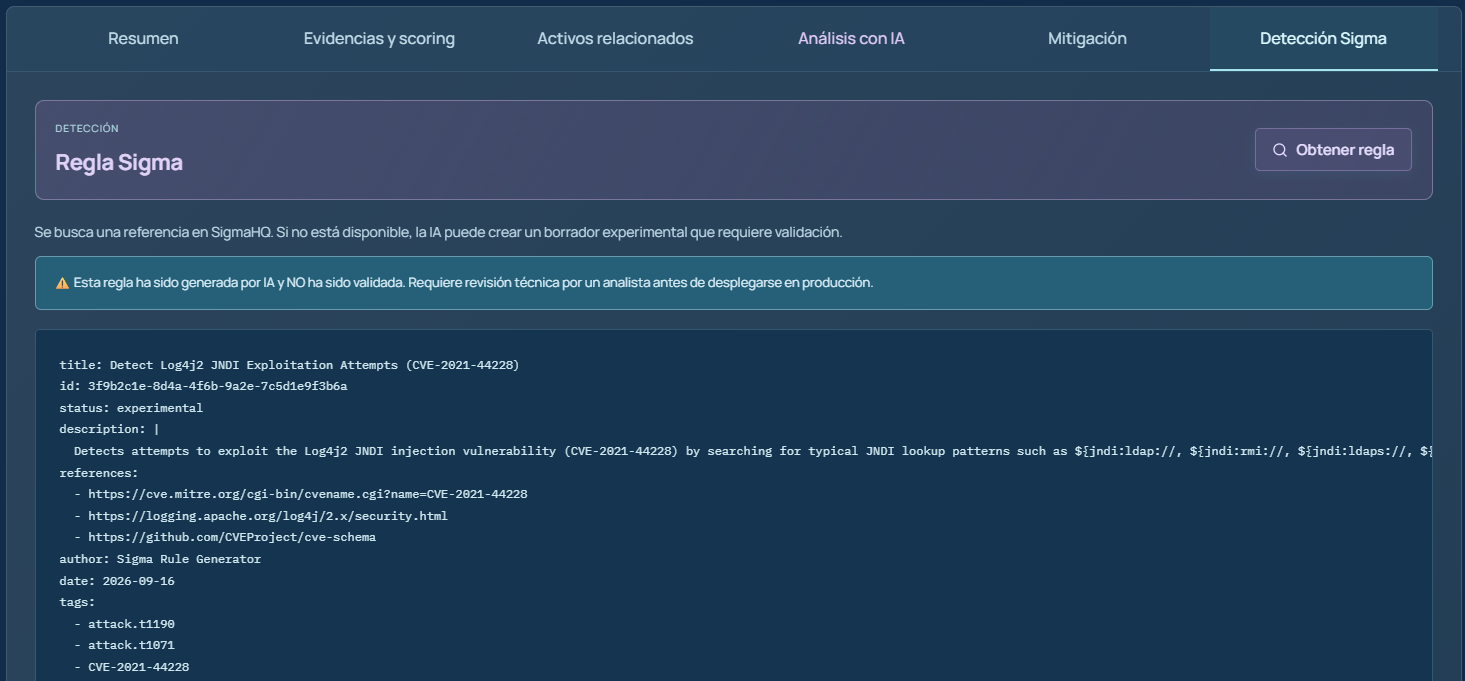
En este último caso la aplicación deja claro que se trata de una detección generada y que necesita revisión antes de utilizarla en un SIEM real.
Para mí esta diferencia es importante: una regla publicada en SigmaHQ y una generada por un modelo no tienen el mismo nivel de confianza, aunque ambas puedan servir como punto de partida para el análisis.
Análisis múltiple
Analizar un único CVE está bien cuando quiero investigar una vulnerabilidad concreta, pero la parte realmente útil de la priorización aparece cuando tengo varias al mismo tiempo.
Por eso añadí una sección de análisis múltiple, donde puedo introducir varios CVEs y aplicar la misma metodología a todos ellos.
VulnSOC los analiza, calcula su prioridad y los ordena para que sea más fácil comparar cuáles merecen atención primero.
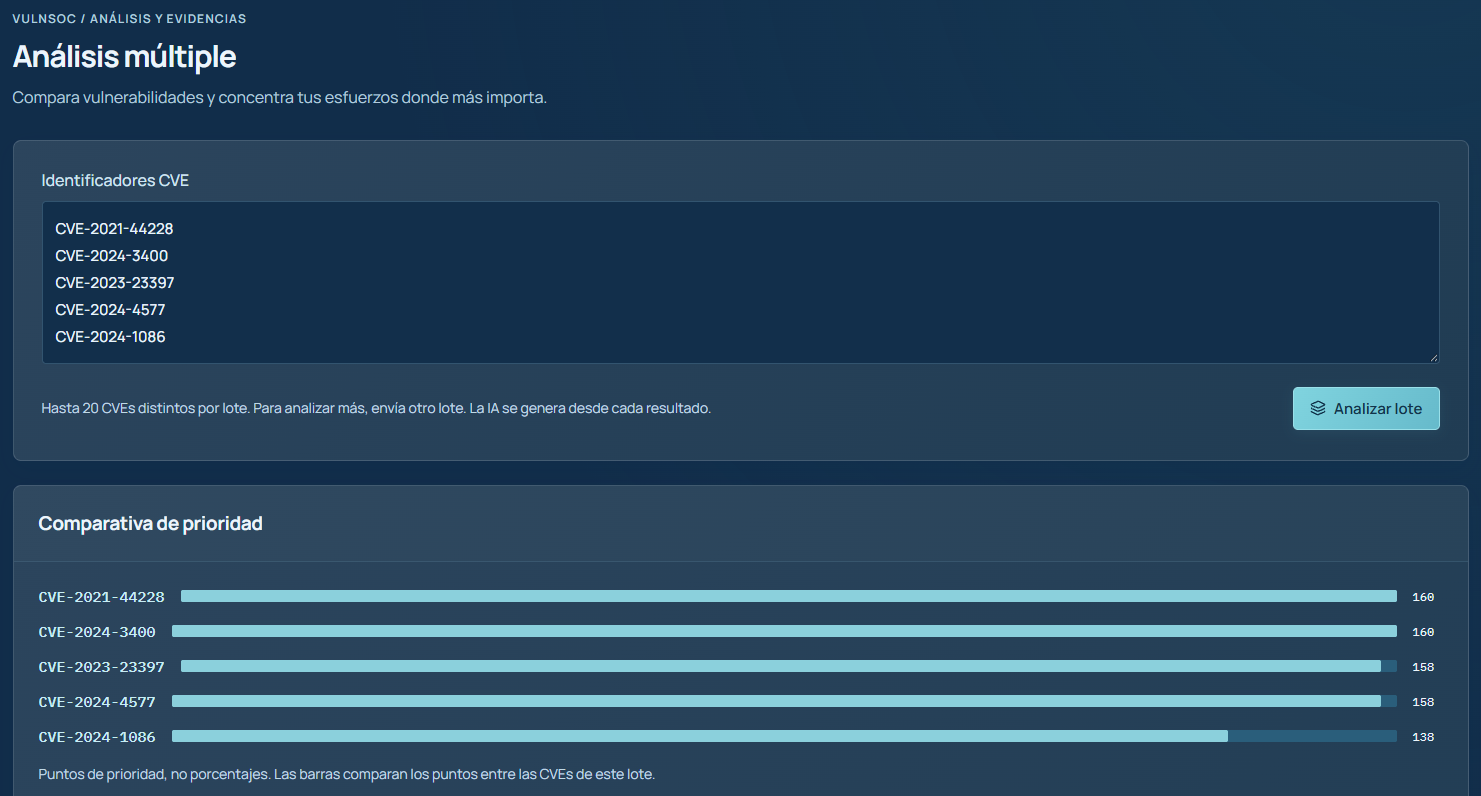
Esta vista es también una de las razones por las que decidí dejar de representar el score como un porcentaje.
Si una vulnerabilidad tiene 160 puntos y otra tiene 110, estoy comparando el resultado de aplicar la misma metodología.
No estoy diciendo que una tenga un 160 % de riesgo.
Historial
Cada análisis puede guardarse en el historial local del navegador para volver a consultarlo más adelante sin tener que empezar de cero.
Desde ahí también puedo buscar, filtrar, eliminar resultados o exportar el espacio de trabajo.
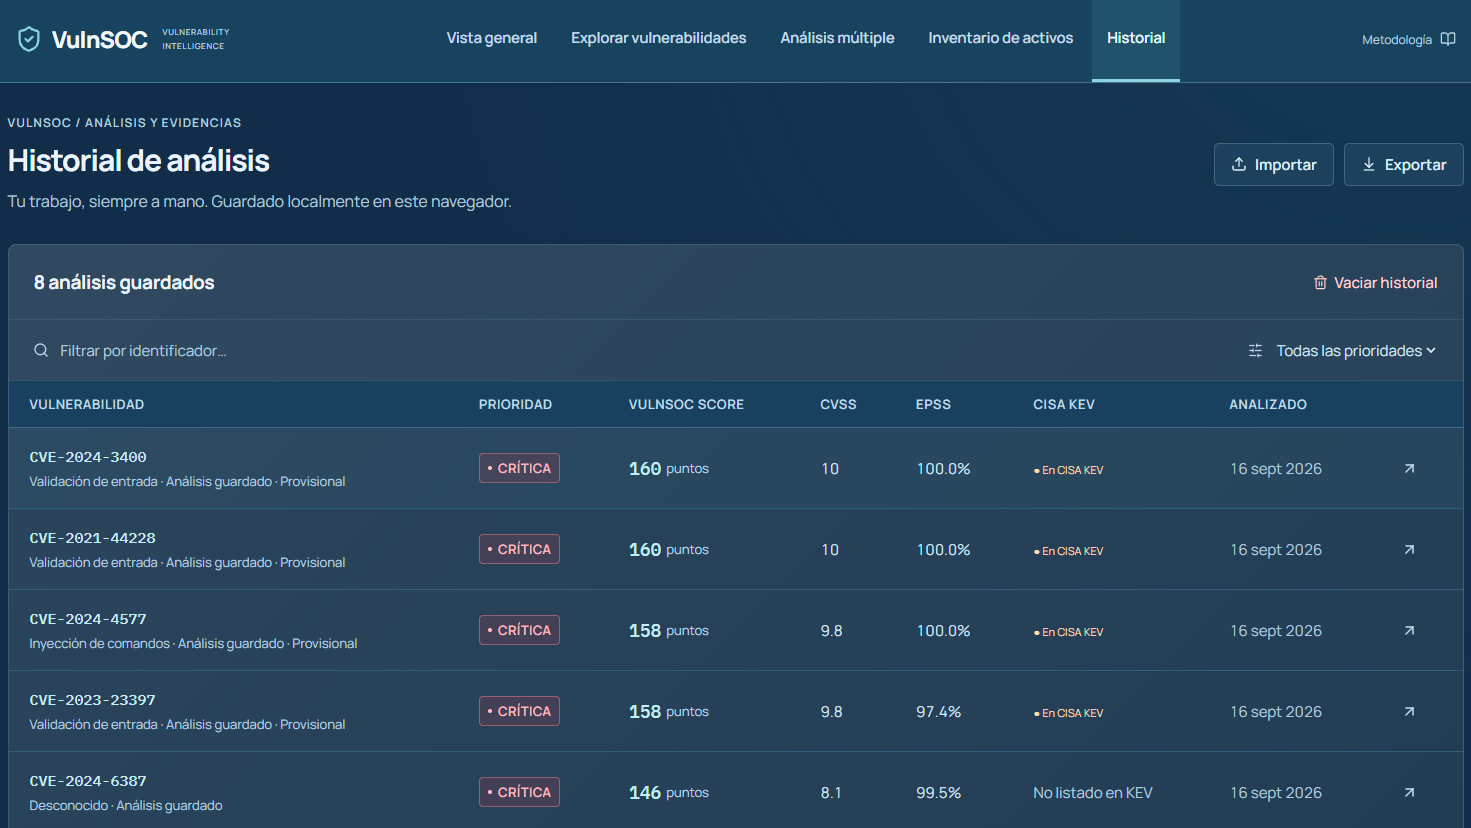
Una decisión que me parecía importante era conservar cada análisis tal y como se generó en ese momento.
La metodología puede evolucionar con el tiempo, pero quería que cada análisis conservara exactamente el resultado que tenía cuando se guardó.
Por eso el historial mantiene el resultado original. Si quiero volver a consultar las fuentes y aplicar la versión actual del scoring, puedo actualizar ese análisis de forma explícita.
Exportación a PDF
VulnSOC también permite exportar cada análisis a un informe en PDF.
La idea es que ese documento refleje exactamente lo que estoy viendo en ese momento sin volver a consultar las fuentes ni recalcular el resultado durante la exportación.
Por eso el PDF funciona como una fotografía del análisis actual.
Puede incluir la prioridad, la puntuación, el desglose del scoring, las evidencias utilizadas, los activos relacionados, las referencias y las secciones generadas mediante IA que estén disponibles.
Explicar la metodología dentro de la herramienta
A medida que el scoring fue creciendo me parecía cada vez más importante que quedara claro de dónde sale la puntuación.
Por eso añadí una sección dentro de VulnSOC donde se explica cómo funciona la metodología, qué fuentes utiliza y qué factores pueden influir en la prioridad final.
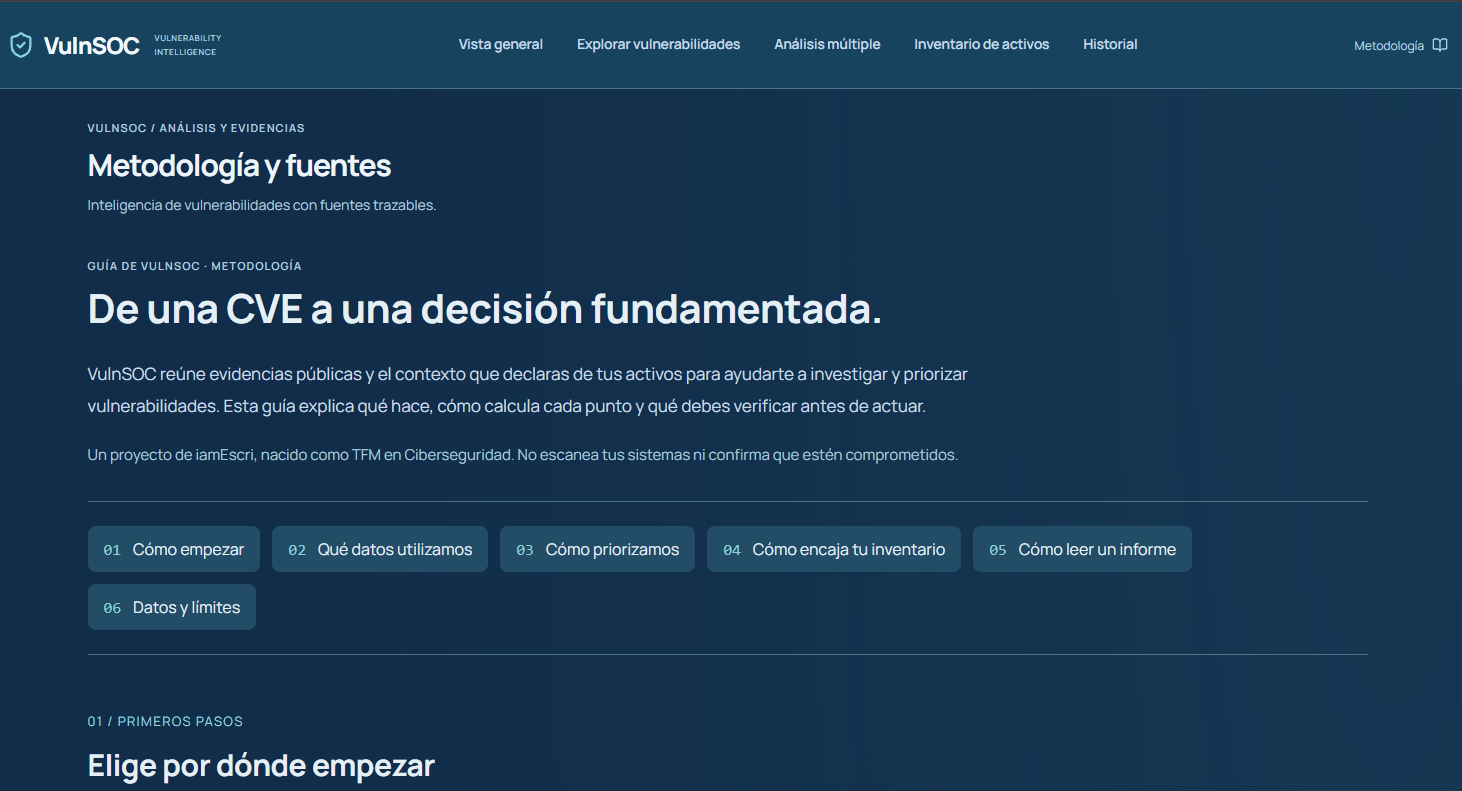
Aquí se pueden consultar los pesos, los umbrales y las principales limitaciones del sistema.
Además de ayudar a entender mejor el resultado y como funciona VulnSOC.
Despliegue
La primera versión de VulnSOC estaba publicada en Streamlit Cloud pero para esta nueva versión quería tener también más control sobre dónde y cómo se ejecutaba la aplicación.
Actualmente VulnSOC está desplegado en un VPS mediante Docker Compose, con los distintos servicios separados en contenedores.
Caddy actúa como punto de entrada desde Internet: sirve el frontend, gestiona HTTPS y envía las peticiones de /api hacia FastAPI. De esta forma la API permanece dentro de la red de Docker y no necesita estar expuesta directamente.
Para un proyecto de este tamaño no necesitaba una infraestructura mucho más compleja. Un VPS con Docker y Caddy me permite mantener VulnSOC publicado con un coste bajo y al mismo tiempo tener bastante control sobre el despliegue.
Además esta parte del proyecto me ha servido para trabajar no solo en el desarrollo de la aplicación sino también en todo lo necesario para mantenerla funcionando y accesible desde Internet
Qué no hace VulnSOC
A medida que fui desarrollando la aplicación también me pareció importante dejar claro hasta dónde llega VulnSOC y qué conclusiones no debería sacar por su cuenta.
VulnSOC no es un escáner de vulnerabilidades. No se conecta a los equipos del inventario para comprobar qué software tienen instalado ni intenta verificar directamente si un sistema está comprometido.
Que una versión sea compatible con una vulnerabilidad tampoco significa que ese activo haya sido explotado. Simplemente indica que según la información disponible existe una relación que merece ser revisada.
El scoring funciona de la misma forma: no representa una probabilidad exacta de sufrir un ataque. Es una metodología propia para ordenar vulnerabilidades utilizando siempre los mismos criterios.
La IA también debe entenderse como una ayuda para interpretar la información y no como una fuente técnica principal. Sus resultados pueden orientar el análisis pero necesitan revisión.
Y hay otra diferencia que intento mantener durante toda la aplicación: fuera de rango no significa seguro. Solo significa que, con los datos que VulnSOC ha podido comprobar, la versión indicada no entra dentro del rango analizado
Lo que realmente cambió respecto a la primera versión
La diferencia visual entre la primera versión y la actual es bastante evidente pero para mí los cambios más importantes no están solo en la interfaz.
La V2 me obligó a revisar muchas decisiones que en la primera versión había resuelto de una forma mucho más simple. Separé frontend y backend, rehice el scoring para evitar factores redundantes y mejoré la forma en la que VulnSOC trata la falta de información.
También revisé bastante la relación entre vulnerabilidades e inventario. Ya no quería que una coincidencia simple fuese suficiente para asumir que un activo podía estar afectado, así que empecé a tener más en cuenta el producto, la versión y la información publicada por las fuentes.
La parte de IA también quedó mucho mejor separada del resto de la aplicación. El scoring y las decisiones principales se calculan de forma independiente, mientras que el modelo se utiliza como apoyo para interpretar y presentar la información.
Además aparecieron problemas que apenas existían en una aplicación local: caché, límites de uso, persistencia, despliegue, HTTPS o fallos de servicios externos.
Ahí es donde más he notado la diferencia entre crear una aplicación para demostrar una idea y mantener un proyecto que está realmente publicado y tiene que seguir funcionando aunque alguna parte falle.
Estado actual
VulnSOC sigue siendo un proyecto en evolución, pero actualmente ya cubre el flujo principal que tenía en mente cuando empecé el TFM.
La aplicación permite analizar una vulnerabilidad, reunir información de distintas fuentes, calcular una prioridad contextual, relacionarla con los activos del inventario y ofrecer información adicional para continuar el análisis.
Aun así todavía hay partes que quiero seguir mejorando.
Una de las principales es la comprobación de aplicabilidad. La información publicada por NVD no siempre tiene el mismo nivel de detalle y los CPE pueden representar situaciones bastante más complejas que una simple comparación de versiones.
También quiero seguir mejorando la trazabilidad de las fuentes y el comportamiento con vulnerabilidades muy recientes, donde muchas veces todavía falta información.
En esos casos prefiero que VulnSOC muestre claramente que algo no se ha podido comprobar antes que intentar rellenar ese hueco con una respuesta que parezca más segura de lo que realmente es.
Conclusión
VulnSOC empezó como la idea principal de mi TFM y perfectamente podría haber terminado cuando entregue el trabajo.
Sin embargo seguir trabajando en el proyecto me ha servido para revisar muchas decisiones de la primera versión y entender mejor hasta dónde puede llegar realmente una herramienta de este tipo.
Con el tiempo me he dado cuenta de que la mejora más importante no ha sido cambiar Streamlit por React ni tener una interfaz más moderna sino aprender a ser mucho más cuidadoso con las conclusiones que muestra la aplicación.
Si falta información no significa que el valor sea cero. Si una versión coincide con una vulnerabilidad, no significa que el sistema esté comprometido. Y si la IA genera una recomendación o una regla de detección, sigue siendo algo que necesita revisión.
Todo esto ha terminado influyendo en prácticamente toda la evolución de VulnSOC.
El objetivo sigue siendo el mismo que tenía al principio: reunir distintas fuentes y aportar suficiente contexto para ayudar a decidir qué vulnerabilidades merece la pena revisar primero.
La diferencia es que ahora el proyecto no solo intenta dar una respuesta, sino también dejar claro de dónde sale esa respuesta y qué cosas todavía no puede afirmar con seguridad.
Proyecto: VulnSOC Assistant
Código: GitHub